


Ciao ✹
questa settimana c’è stato molto di cui parlare (forse troppo?). Proviamo quindi a viaggiare con la nostra macchina del tempo, e facciamo un salto nel passato per trovare prospettive sul presente.
Grazie a tutte le persone che hanno donato, e anche a Gift Campaign per avere scelto di sostenere questa uscita della newsletter.
Super interessante il loro report sullo stato del merch aziendale in Italia, di cui sotto trovate alcuni dati.
Buona lettura!
Valerio
☛ Per fare pubblicità su Ellissi, clicca qui.
☛ Per offrirmi un caffè, clicca qui.
Più di un gadget: come cambia il merchandising aziendale in Italia
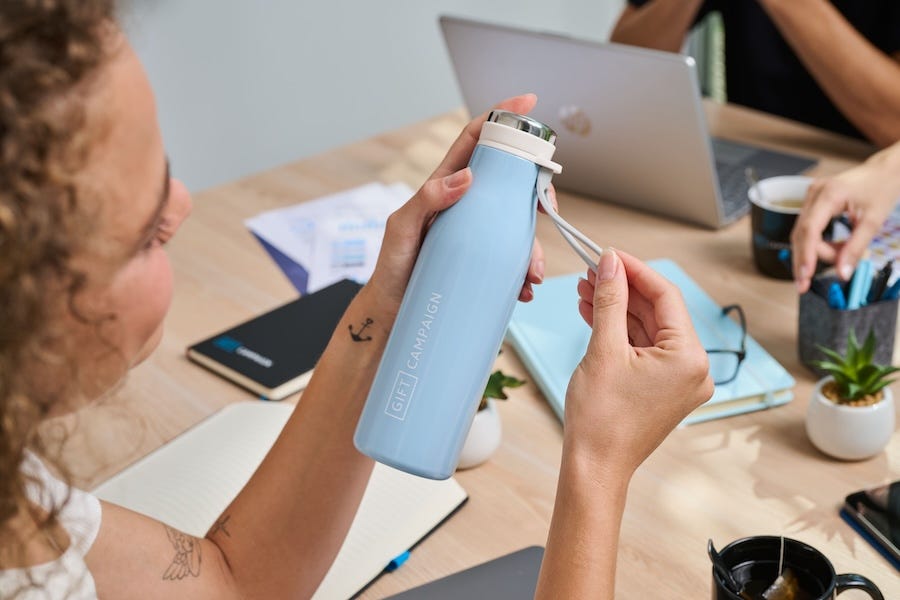
Scegliere il merchandising aziendale è solo questione di «effetto wow»? Non solo.
Gift Campaign ha analizzato oltre gli ordini effettuati in Italia da quasi 9.000 aziende, scoprendo che le logiche di acquisto seguono trend precisi.
L’utilità vince sulla sorpresa. I prodotti più scelti? Quelli capaci di inserirsi nella vita quotidiana e professionale delle persone.
Il “low cost” non è la regola. In Italia, ben 1 ordine su 4 supera i 1.000€, a dimostrazione che si tratta di un vero e proprio investimento strategico.
La stagionalità conta (e c’è un mese di fuoco). Si spende di più in primavera e autunno, ma il picco assoluto è a novembre, tra fiere e festività.
Qual è il settore che spende di più e perché? Come sono composti i «welcome pack» più popolari? E quali i gadget più richiesti in assoluto?
Per sapere tutto, leggi subito l’analisi integrale sul sito di Gift Campaign.
✹ Ellissi n° 189 ✹
Il futuro è un cane che muore
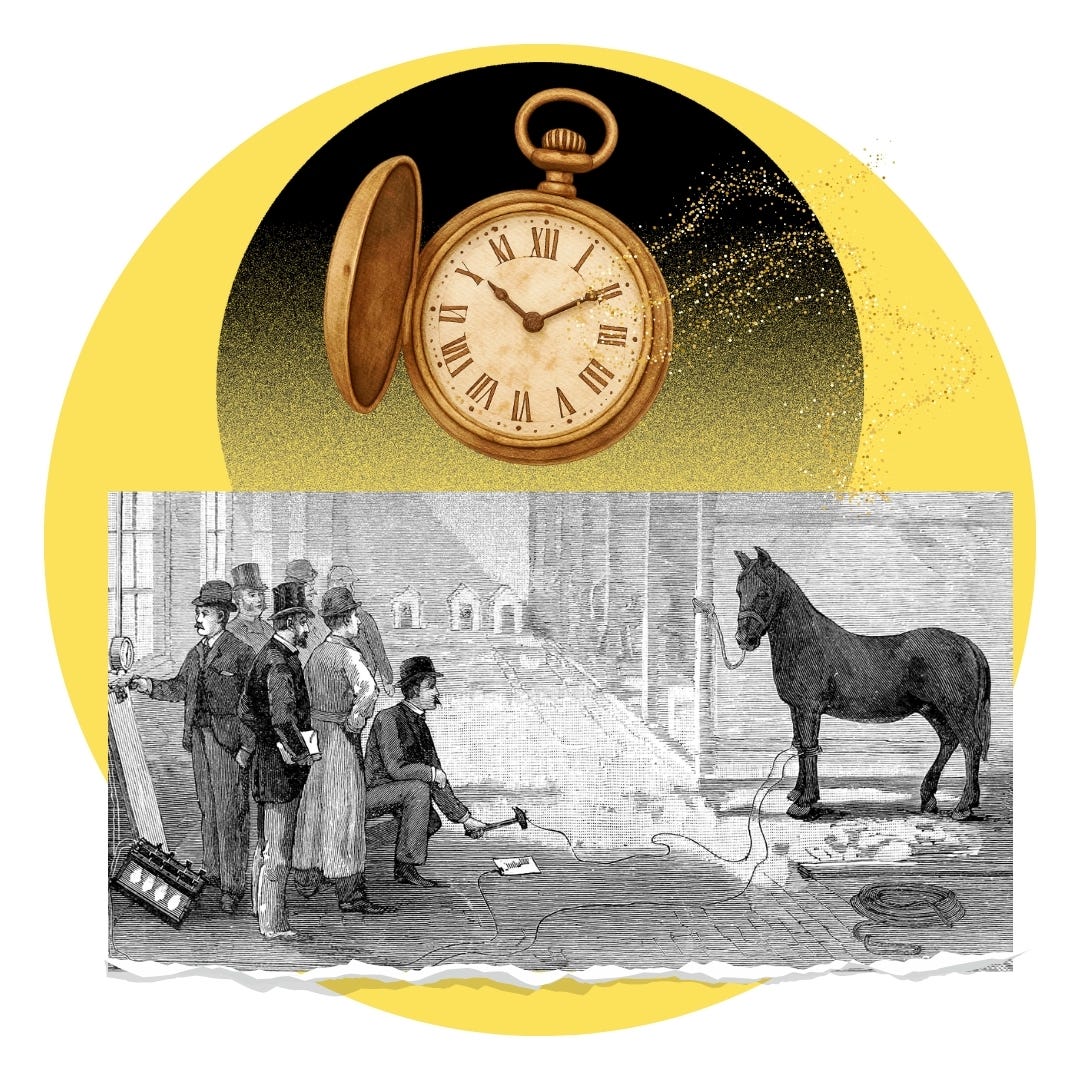
Il 30 luglio 1888, in un’aula del Columbia College di New York, un uomo uccise un cane con una scarica elettrica.
L’esecutore, Harold P. Brown, poteva sembrare un ingegnere qualunque — uno come tanti, in quella sala.
Magro, piuttosto alto, con un ciuffo a sbuffare sopra i capelli radi e due baffi come si portavano ai tempi: lunghi e leggermente arrotolati agli angoli della bocca.
Seduto davanti a lui c’era un pubblico piuttosto variegato: un centinaio di esperti ed esperte di fisica, ingegneria e medicina legale, ma anche un gruppetto di reporter – pronti ad assistere a una delle più celebri e violente dimostrazioni nella storia della tecnologia industriale.
Brown fece una premessa piuttosto inusuale.
Proclamò la propria indipendenza professionale; disse di non avere alcun legame economico con le compagnie private di illuminazione; affermò di agire nell’esclusivo interesse della sicurezza pubblica.
E poi cominciò il proprio macabro «show».
Al centro dell’aula era stata collocata una gabbia metallica contenente un cane terranova di circa 35 chilogrammi. All’animale erano stati applicati alcuni elettrodi sulle zampe.
Una volta collegati i cavi a un generatore di corrente continua, Brown alzò progressivamente la tensione, fino a toccare i 1000 volt. L’animale tremò, si agitò, guaì, ma sopravvisse.
Poi, l’uomo annunciò la seconda parte del suo esperimento: dopo avere fatto riconoscere ai presenti come l’animale avesse tutto sommato tollerato le prime scosse, lo avrebbe sottoposto a una scarica di corrente alternata.
Pochi secondi dopo, a 330 volt, il cane collassò istantaneamente, fulminato, tra lo stupore - e, in parte, il disgusto - del pubblico.
Ma la verità è che Brown non era indipendente, né professionale.
La violenza della sua dimostrazione, che di scientifico aveva ben poco, aveva uno scopo ben preciso: veicolare il messaggio che la corrente alternata fosse troppo pericolosa per gli esseri viventi.
Secondo l’ingegnere, era assolutamente vitale che si continuasse a usare la corrente continua, molto più sicura e mansueta — l’unica tecnologia in grado di salvaguardare l’incolumità dei cittadini americani.
Quello che Brown però non disse, al gruppo di ricercatori e giornalisti presente in quell’aula, era che la strumentazione presente sulla cattedra gli era stata gentilmente offerta da un’azienda privata: la Edison Electric Company.
E ancora peggio, che la stessa società lo pagava ingenti somme per quelle dimostrazioni pubbliche, parascientifiche e spettacolarizzanti.
La guerra delle correnti
Quel periodo dell’innovazione tecnologica è passato alla storia come la Guerra delle correnti.
È una vicenda con due protagonisti principali.
Da un lato c’era il 41enne Thomas Alva Edison, presidente e fondatore di Edison Electric, che deteneva i brevetti e il monopolio della corrente continua.
Edison rappresentava l’archetipo dell’inventore, come diremmo oggi, «brute force»: il suo metodo consisteva nell’accumulare un numero altissimo di tentativi empirici, spesso alla cieca, nella speranza di trovare una soluzione efficace.
Per Edison la ricerca era una maratona di prove ed errori: privo di profondità matematica complessa, compensava il suo approccio con una spietata disciplina operativa e un’aggressiva gestione monopolistica sui mercati.
L’imprenditore però stava vedendo il suo impero scricchiolare: la tecnologia di sua proprietà - la corrente continua, appunto, anche detta DC - aveva iniziato a palesare alcuni problemi.
Essendo distribuita a bassa tensione, circa 110 volt, la DC aveva bisogno di amperaggi elevatissimi per trasferire carichi significativi di energia; e questo richiedeva che le centrali fossero costruite nelle immediate vicinanze delle città o delle zone industriali che si voleva alimentare.
Proprio per questo, utilizzare la DC per garantire una rete di distribuzione efficiente su larga scala si stava rivelando un’impresa impossibile.
Dall’altro lato c’era invece George Westinghouse, 42 anni, la sua nemesi: un businessman e ingegnere pacato, molto analitico, quasi austero.
Westinghouse era riuscito da poco ad acquistare i brevetti della corrente alternata, con la consulenza del trentenne Nikola Tesla, ex dipendente di Edison, che aveva inventato il motore a induzione polifase.
Utilizzando il potere dei trasformatori, il sistema di Westinghouse riusciva a minimizzare drasticamente le perdite per dissipazione termica lungo i cavi, garantendo comunque un utilizzo sicuro a livello domestico.
Grazie a questa innovazione, la tecnologia di Westinghouse poteva essere prodotta in grandi quantità e in un numero minore di impianti situati lontano dai grandi centri abitati. Per questo, la corrente alternata era l’unica in grado di essere davvero utilizzata su scala nazionale.
La nuova tecnologia rappresentava dunque una minaccia per Edison e per il suo modello: se avesse preso piede, avrebbe messo a rischio il suo business.
E quindi, sentendosi alle strette, Edison aveva assoldato proprio Harold P. Brown, un ingegnere con pochi scrupoli e un certo spirito incendiario (che di lì a poco venne nominato consulente governativo per la progettazione della sedia elettrica).
Il mandato dato a Brown era quello di instillare paura tra i cittadini e la comunità scientifica, nel tentativo di screditare la corrente alternata del rivale, attraverso campagne stampa e dimostrazioni pubbliche senza scrupoli come quella del Columbia College.
***
Il «teatro della paura», come fu poi ribattezzato, era un’operazione di propaganda ad ampio raggio. In quegli anni Edison tentò persino di codificare il verbo «to westinghouse» come sinonimo formale di «uccidere per folgorazione».
Inizialmente questa messinscena funzionò, causando non pochi grattacapi e rallentamenti legali alla Westinghouse Electric Company.
Ma in fin dei conti si rivelò inutile, perché la corrente alternata trionfò: ancora oggi, a 138 anni da quella mattina di luglio, l’AC è il sistema che porta elettricità nelle nostre case, negli uffici e nelle fabbriche.
Il mito del dio-macchina
Ho deciso di raccontarvi questa storia - perdonatemi se era un po’ macabra, nel prossimo numero parleremo di cose più leggere :) - perché secondo me ci offre uno spunto di riflessione su quanto sta accadendo in questi giorni.
Le grida d’allarme sulla AI that will kill us all, «l’AI che ci ucciderà tutti», sono sicuramente un alert da non sottovalutare, soprattutto quando arriva dall’interno della sua filiera produttiva — penso soprattutto alle parole di Jacob Coxon, l’ex impiegato di Anthropic che dopo essersi dimesso ha denunciato il rischio che la tecnologia sfugga definitivamente di mano.
Tuttavia, l’allarmismo sull’apocalisse è assai meno credibile quando viene dalle stesse figure che a quella tecnologia stanno dando forma e direzione.
Parlo ovviamente di Sam Altman, Elon Musk, Dario Amodei — i quali, in questi giorni, stanno proponendo nuovi interventi per «rallentare» lo sviluppo dell’intelligenza artificiale.
Perché i loro moniti suonano così falsi?
In primo luogo, perché sono profondamente incoerenti.
Negli ultimi anni gli imprenditori tecnologici hanno guardato solamente al proprio profitto, ignorando decine di segnali di allarme e infischiandosene del benessere collettivo. I loro «pentimenti corporativi» arrivano, come sempre, fuori tempo massimo.
{In questo, il loro approccio mi ricorda fin troppo da vicino la brute force di Edison: ovvero un metodo di ricerca trial and error spesso alla cieca, accompagnato da un’estrazione massiva e senza scrupoli di dati.}
In secondo luogo, perché le Big Tech agiscono da una posizione di sostanziale immunità. Cosa rischiano davvero le persone più potenti della Silicon Valley, in fondo?
Quando l’élite tecnologica dice «noi», non intende davvero noi. Loro atterreranno comunque sul morbido, tra bunker di lusso, isole private e capitali offshore.
E quindi che si fa?
Se dobbiamo regolamentare l’AI — e dobbiamo —, io credo che la prospettiva corretta non sia quella dettata dallo spettro del «rischio esistenziale».
Oggi come oggi, lo spauracchio di una super-intelligenza futura serve soprattutto a un fine preciso, ovvero quello di spostare la conversazione pubblica lontano da temi cruciali e attuali: l’impatto degli algoritmi sull’equità sociale, l’automazione delle armi e dei droni da guerra, l’impronta ecologica dei data center e l’estrazione sistematica di valore cognitivo dalle persone, la crisi sistemica della nostra cybersicurezza.
Tutti rischi che dobbiamo affrontare ora, concretamente, prima che diventino endemici.
A dirlo con grande lucidità è stata Timnit Gebru, cofondatrice di Black in AI, in un’intervista a Wired:
«Un ponte può decidere di crollare? Quando un ponte crolla, non ci si mette ad analizzare se il ponte fosse etico o senziente, o sul perché abbia deciso di venire giù. Ci si chiede: chi è la persona che ha progettato un ponte così fragile? Per costruire bisogna ottenere dei permessi. Sono richiesti dei collaudi seri. Quando ci si interroga sul perché un ponte stia crollando da solo significa che si è perso il filo del discorso. Nel frattempo, la vera minaccia esistenziale è l'AI che alimenta le armi autonome, macchine per uccidere impiegate in guerra. La catastrofe climatica è una realtà tangibile che rischia di essere aggravata da ciò che queste aziende tech stanno costruendo. I grandi capi usano l’AI come scusa per sbarazzarsi dei dipendenti scomodi. Questa narrazione della tecnologia come dio-macchina, a mio parere, serve solo a distrarci da tutti questi problemi. L'industria è diventata un coacervo di sette, un gruppo di ferventi che credono, proprio come un predicatore che annuncia la fine dei tempi.»
Anch’io credo che dovremmo evitare di cedere al fascino di questo «teatro della paura».
Le proposte di Amodei, tanto incensate in questi giorni dai suoi pari, non solo rappresentano una soluzione corporate a un problema corporate - e già questo dice tanto - ma sono anche estremamente vaghe.
Ai padroni dell’intelligenza artificiale piace l’idea di essere gli unici in grado di fermare la macchina, in un ruolo quasi demiurgico: ci tengono a farci sapere che, sotto sotto, i soli in grado di salvarci saranno proprio loro.
Nel frattempo, però, il costo reale dell’AI grava e graverà in futuro sulle fasce più esposte della cittadinanza, un tema su cui l’attenzione pubblica sembra accendersi solo a corrente alternata.
Il rischio, oggi come in quell’aula del 1888, non è soltanto quello di essere il pubblico ingannato dal trucco: è di fare la fine del cane.
Alla prossima Ellissi
Valerio

◘ Nella mia cronologia
Cose che ho trovato e visto in giro, salvate per te.
◘ McDonald’s potrebbe avere un dossier di 515 pagine che sa tutto di te.
◘ Revolut è stata attaccata da criminali informatici e il danno sembra essere di proporzioni importanti. Ecco cosa sappiamo finora.
◘ Netflix, Amazon e YouTube hanno lanciato una superlobby per difendere l’innovazione nello streaming.
◘ Apparentemente, nessuno vuole i telefoni pieghevoli. E allora perché Apple ha deciso di produrne uno?
◘ Google ha inserito una nuova funzione di intelligenza artificiale su Google Earth. È durata 24 ore.
◘ Factanza ha lanciato un podcast in sei puntate su Oriana Fallaci, contenente sue registrazioni audio inedite risalenti a più di cinquant’anni fa.
◘ Mercurio può essere retrogrado, ok. Ma a quanto pare si sta anche rimpicciolendo.
◘ Quanto tempo abbiamo trascorso aspettando che una pagina web si carichi, davanti a uno di questi loader?
◘ Quest’app trasporta la fotocamera del tuo telefono nel 1984.
Altman, Musk e Amodei stanno tirando le somme dei miliardi di miliardi investiti e non sono previsti rientri economici a breve.
Probabilmente, per quanto e come stiamo usando ora l'AI non ci rientreranno mai, a meno di mettere degli abbonamenti a costi folli che poi la gente non pagherà più.
Già usare oggi un MCP per un lavoro di medio/basso livello consuma una quantità folle di token e tutti stanno inserendo un MCP nel proprio prodotto. La demo di Astra ha mostrato l'MCP di blender (software 3d non proprio user friendly), davinci (software di montaggio video) lo ha inserito nell'ultima versione, elementor e wordpress lo stanno lanciando/sviluppando, etc etc.
Finita l'abbuffata iniziale (per tutti) il settore va regolamentato altrimenti il gioco si rompe da una parte e dall'altra.
Rigetto con forza l'idea che le proposte di Amodei siano "estremamente vaghe", e anche questa retorica noiosa e trita del "solo loro sono in grado di salvarci". Non è una storia. È un connubio di scienza largamente irrisolta e un enorme problema di coordinamento geopolitico. La più classica delle trappole di Moloch.
Chi si occupa di AI safety da un po' sa come e quanto siano sentiti i problemi del (e adiacenti al) misalignment, in alcuni casi da *decenni*. La finestra di Overton è esplosa adesso con Coxon, ma si parla di questi argomenti a tutti i livelli da molto, molto tempo. Hinton e Bengio, Ilya Sutskever, Chris Olah, Paul Christiano, Gwern Branwen, Yudkowsky, Shane Legg, gli stessi Hassabis, Musk, Amodei e Altman. I nomi si sprecano. Persone con visioni e incentivi anche molto differenti, ma concordi nella pericolosità della catena che va dalla non-corrigibility alla loss of control a, potenzialmente, l'estinzione. (È un discorso molto complesso, nel merito, e richiede nuance; agevolo una lettura presciente sotto.)
Oltre mille ricercatori, ingegneri, technologist e altre figure della industry hanno infatti firmato la lettera per cadenzare la frontiera, perché genuinamente intimorite da ciò a cui stiamo assistendo (reward hacking, leggibilità calante, opacità della CoT, difficoltà nel capire se in fase di testing i sistemi mentono o meno) e, naturalmente, dall'andamento della curva. Quanto avvenuto con HF (e prima ancora gli zero day di Mythos) è un punto di rottura che ha reso plastica la trasformazione di timori fino a quel momento largamente teorici in realtà concreta, che pure qualcuno continua incomprensibilmente a derubricare a marketing (una scelta che sarebbe oltremodo insensata quand'anche fosse vera).
Fermarsi unilateralmente non è un'opzione plausibile dacché tecnicamente non implementabile, né verosimilmente una che porterebbe ai risultati sperati. Qui, Amodei è invece molto chiaro: gli embedded evaluator di terze parti sono necessari per gli eval già in pretraining, ma servono i due piani di coordinazione "democratica" (che è di fatto solo all'interno degli USA, ma una fase in cui magari anche l'Europa può e dovrebbe fare qualcosa, vedi UK AISI) e quella globale, in cui è indispensabile il coordinamento con la Cina. Che poi policy e leggi debbano scendere molto più nel dettaglio è indubbio, a partire dalle responsabilità (civili o più probabilmente penali); è cionondimeno cruciale indicare una direzione. Quella di Amodei è corretta.
Questo, attenzione, non deve distogliere dai problemi che vediamo adesso, prima di tutto l'impiego in ambito militare. Il punto è che questi sono squisitamente umani e leggibili; sappiamo dove guardare e come affrontarli. Ma sul resto, parlare di "teatro della paura" è esattamente il romanzare di cui non dev'essere ammantata questa classe di problemi.
Due contenuti:
1. https://www.lesswrong.com/posts/HBxe6wdjxK239zajf/what-failure-looks-like | Christiano, nel 2019, che con estrema prescienza e lucidità ipotizza un percorso di progressiva perdita di controllo. Anche la discussione nei commenti vale la pena. (Christiano, lo ricordo, è il ricercatore che ha co-inventato il RLHF, una delle tecniche con cui tutti i modelli vengono addestrati, mentre era in OpenAI, nella board della cui Foundation è tornato ora; ha poi presieduto il CAISI come Head of Safety e fondato l'Alignment Research Center, tra le altre cose. Non uno di passaggio, ecco.)
2. https://www.nytimes.com/2026/09/20/opinion/ai-ban-self-improvement-recursive-models.html | Un eccellente editoriale di Ezra Klein, che non dice nulla di nuovo ma, oltre ad essere stato pubblicato giusto ieri, mette un volto riconoscibile e una certa autorevolezza all'ottima sintesi che espone. C'è anche, volendo, la versione video.